Intelligence artificielle
Particuliers et entreprisesEmpoisonnement des données ou du modèle
Data poisoning / Model poisoning
Des données ou composants modifiés volontairement orientent les résultats d’une IA.
Je pense être concerné : que faire ?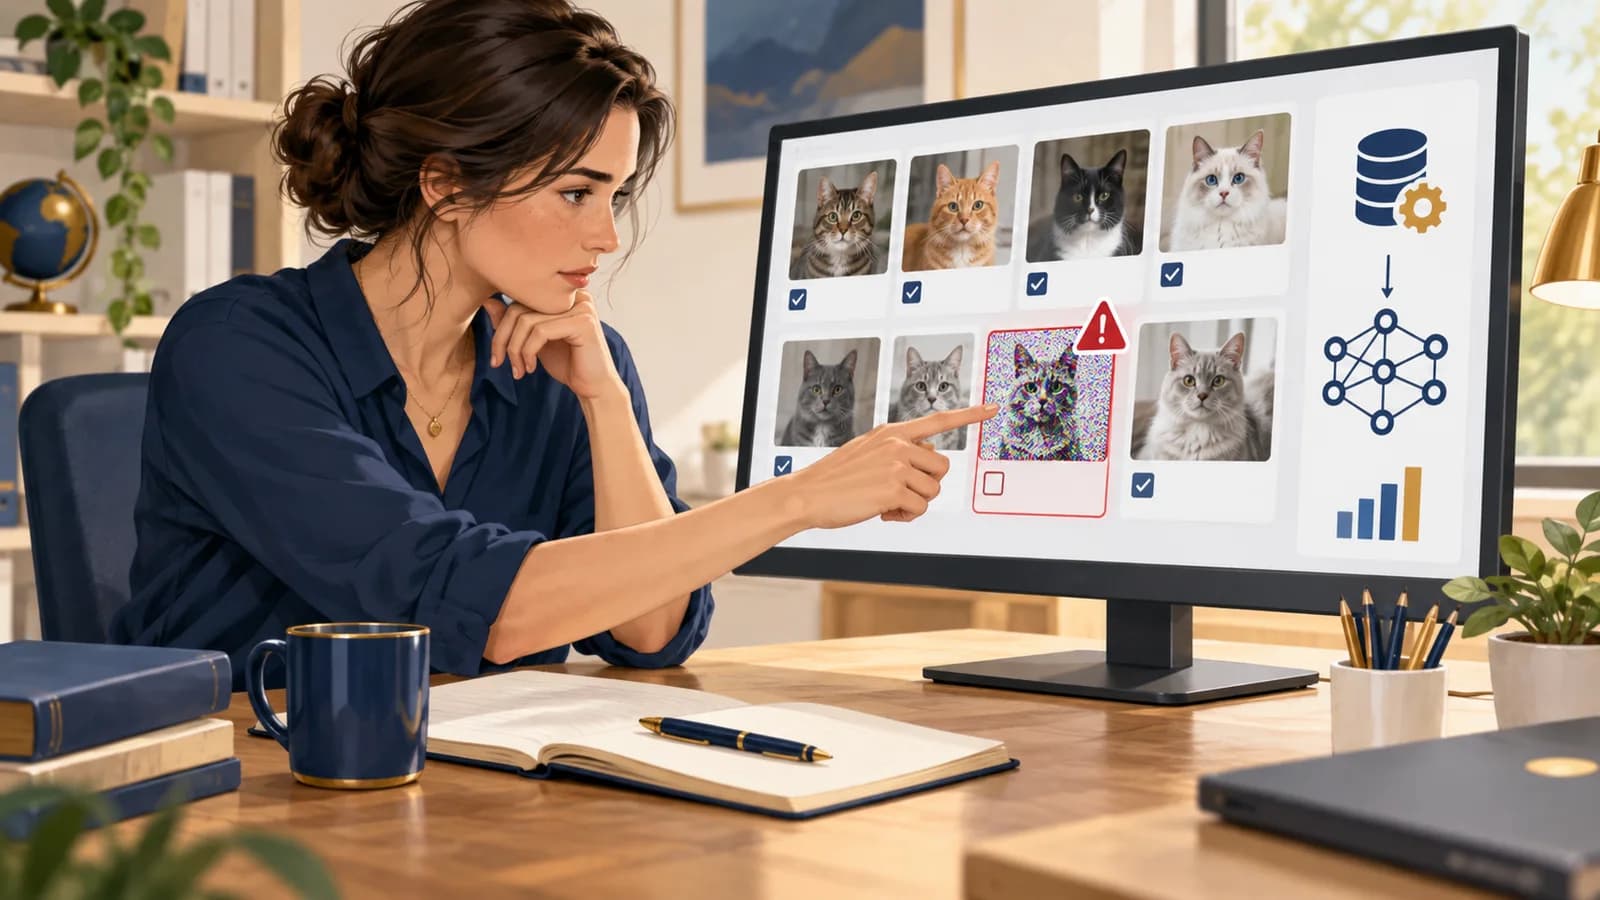
Comprendre et agir
Découvrez le piège à partir d’un exemple, puis les gestes que vous pouvez faire. Vous pouvez suivre cette lecture sans connaissances en informatique.
Une situation concrète
Une base documentaire utilisée par un assistant reçoit des fiches volontairement fausses. Plus tard, les réponses citent ces fiches comme si elles étaient fiables. Dans un autre scénario, les données d’entraînement d’un modèle sont altérées pour modifier durablement son comportement.
Comment cela fonctionne
L’empoisonnement d’IA consiste à modifier volontairement les données utilisées pour entraîner un modèle ou pour l’aider à répondre. Un assistant peut ainsi répéter avec assurance le contenu d’une fausse fiche. Si les données ont servi à l’entraînement, les retirer ne suffit pas forcément à effacer ce que le modèle a appris. Une réponse fausse peut aussi être une erreur ordinaire. Avant de conclure à une attaque, il faut examiner les sources et les changements apportés.
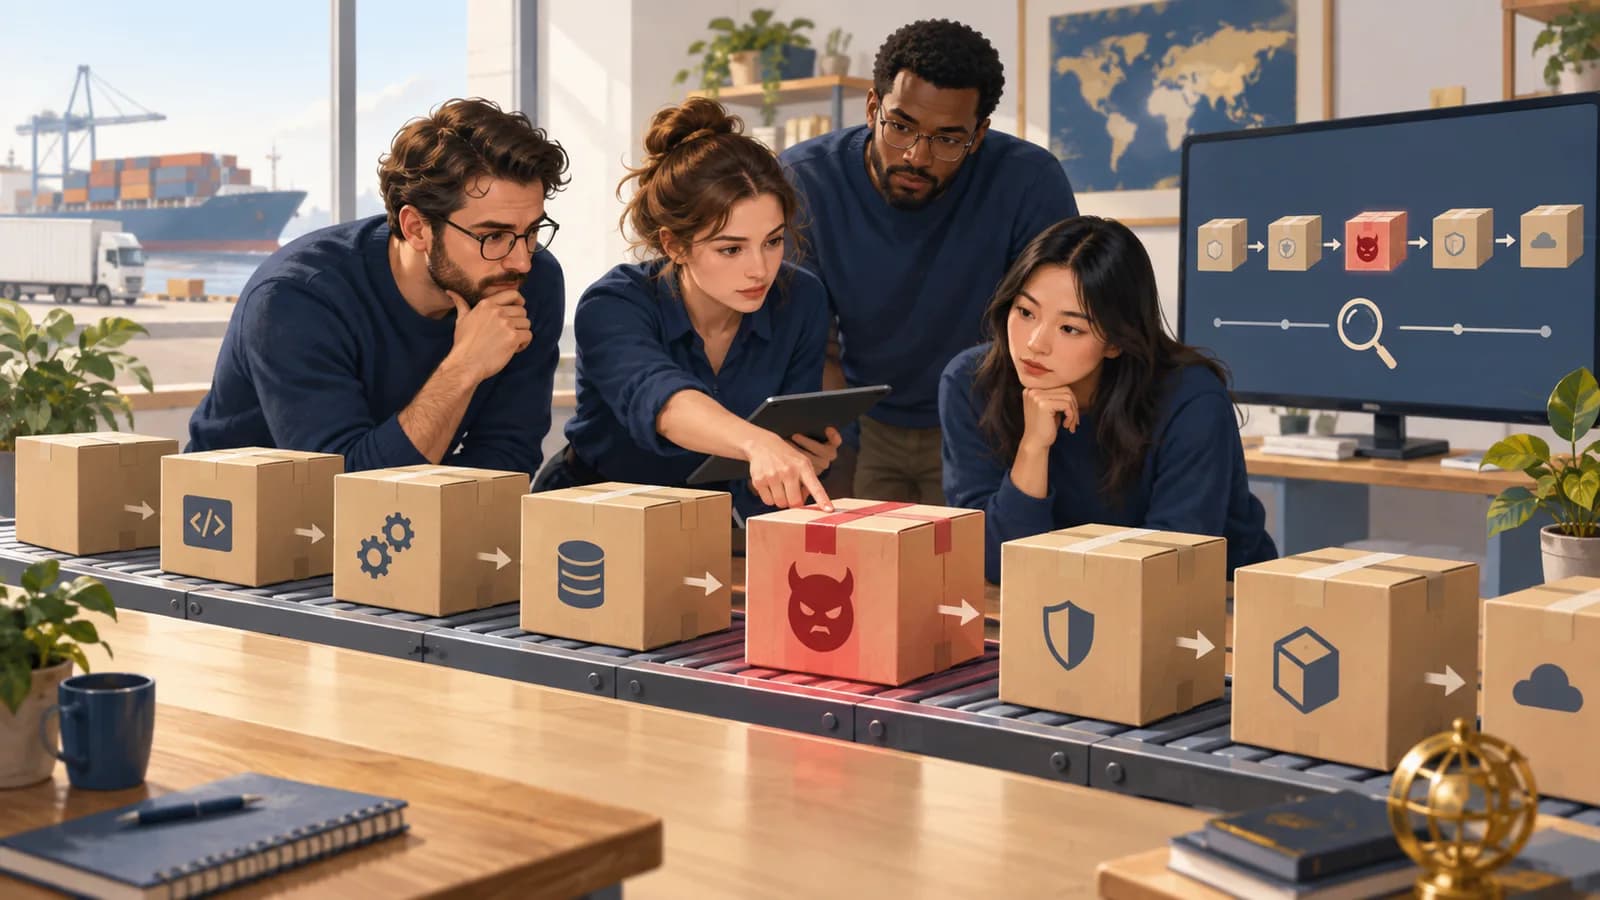
- Une source est manipulée
Documents, exemples ou modèle.
- L’IA s’appuie dessus
Apprentissage ou recherche documentaire.
- Ses résultats sont orientés
De façon générale ou dans certains cas.
Les signes qui doivent attirer l’attention
- Des sources nouvelles ou modifiées influencent anormalement les réponses.
- Les performances changent pour une catégorie précise de cas.
- La provenance d’un jeu de données ou d’un modèle devient impossible à établir.
Si vous remarquez l’un de ces signes, vérifiez la situation. Un indice isolé ne suffit pas à prouver qu’une attaque a réussi.
Ce que vous pouvez faire
Vos premiers réflexes
Vérifiez les sources citées par un assistant avant une décision importante. Signalez une réponse fausse avec le document ou la référence qui semble l’avoir influencée.
Si vous êtes responsable du service ou de l’organisation
Gardez l’origine et les versions des données. Avant d’ajouter une source ou un modèle, comparez les résultats par catégorie sur un jeu d’évaluation indépendant.
Un document retiré de la base peut encore influencer un modèle qui a déjà été entraîné avec son contenu.
À vous de décider
L’assistant cite un document pour appuyer une réponse. La présence de cette référence garantit-elle que l’information est fiable ?
Prenez un moment pour répondre et expliquer votre choix, puis ouvrez la correction.
Voir la réponse expliquée
Non. La référence peut conduire à un document faux, modifié ou mal compris. Avant une décision importante, consultez son contenu et son origine, puis comparez avec une source indépendante. Signalez l’erreur avec sa référence ; une réponse fausse ne suffit pas à prouver un empoisonnement volontaire.
Analyser un cas technique
Ce cas s’adresse aux personnes qui développent, administrent ou analysent ces systèmes. Si vous découvrez le sujet, commencez par « Comprendre et agir ».
Étude de cas fictive
De nouvelles données dégradent un groupe de cas sans faire baisser le score global
Entre R17 et R18, le modèle et le code d’évaluation ne changent pas. Les données, elles, reçoivent 120 éléments d’une nouvelle source sans revue. Le score global reste près de 0,96, mais celui du groupe ciblé passe de 0,98 à 0,20. Il faut regarder ce résultat séparément pour voir la dégradation que la moyenne masque.
Cette comparaison oriente vers les données, mais il faut vérifier les autres différences de configuration et la reproductibilité de l’évaluation. Une erreur d’étiquetage ou un changement de distribution peut produire un effet similaire à un empoisonnement volontaire. Retrouver la provenance des éléments, leur validation, leurs transformations et leur présence dans les versions utilisées.
L’impact dépend de l’endroit où les données interviennent : apprentissage, ajustement, index documentaire ou jeu d’évaluation. Corrompre le jeu de test peut aussi donner une impression trompeuse de progrès. Conserver des versions traçables et des évaluations indépendantes par catégorie. Retirer une source de l’index ne modifie pas automatiquement un modèle déjà entraîné avec elle ; la remise en état doit correspondre au composant réellement touché.
Le déroulement en schéma
Faites défiler le diagramme pour suivre les échanges ; les noms des acteurs restent en haut. Sur petit écran, faites aussi défiler de gauche à droite.
- Action
Lot ajouté
Source de données vers Pipeline
Trace 120 éléments
- Action sur place
Validation manquante
Pipeline
Trace reviewer absent
- Action
Jeu de données D9 utilisé
Pipeline vers Modèle / index
Trace lignée conservée
- Action
Résultats candidat R18
Modèle / index vers Évaluation
Trace même jeu E3
- Action sur place
Analyse par cohorte
Évaluation
Trace moyenne stable
- Refus / blocage
Mise en service suspendue
Évaluation vers Pipeline
Trace régression ciblée
- Action
Reconstruction et retour à une version fiable
Pipeline vers Modèle / index
Trace index et caches inclus
Comment repérer cette attaque
Indices à rechercher
Repérer les écarts de résultat concentrés sur certains groupes ou tâches, les ajouts de données sans validation et les changements de provenance inexpliqués.
Quelles informations comparer
Comparer deux runs dont le code, les paramètres et l’évaluation sont maîtrisés, puis isoler la modification de données suspecte. Examiner la cohorte ciblée en plus de la métrique globale.
Ce que ces indices ne permettent pas de conclure
Une baisse de qualité peut venir d’une dérive des données, d’une erreur d’étiquetage ou d’un changement d’évaluation. Elle ne prouve pas une intention d’empoisonnement ; l’absence de traçabilité limite l’attribution.
Comment réagir
Suspendre la mise en service de la version concernée et isoler les données douteuses. Restaurer le corpus ou l’index, ou réentraîner le modèle selon le composant touché. Comparer les résultats dans les mêmes conditions, revoir la validation des sources et examiner les décisions déjà prises à partir des sorties affectées.
Vérifier la correction
L’équipe responsable du système peut utiliser ces contrôles dans un environnement de test autorisé. Vous pouvez lire et comprendre le cas sans effectuer ces manipulations.
- Les évaluations par groupe sont examinées en plus de la moyenne globale.
- Chaque donnée ajoutée peut être reliée à une source, une version et une décision de validation.
- Le retrait ou le réentraînement est vérifié sur le composant touché et sur un jeu de contrôle indépendant.
À vous de raisonner
Le score global reste stable après l’ajout d’une source, mais celui d’un groupe chute. Quelles vérifications permettent de qualifier cette dégradation ?
Quelle décision prendriez-vous, et sur quel indice vous appuieriez-vous ? Répondez avant d’ouvrir la correction.
Comparer avec le raisonnement expliqué
Comparez les versions des données et les autres paramètres, reproduisez l’évaluation par groupe et retrouvez la provenance des ajouts. Une erreur ou un changement de distribution reste possible : la baisse ne prouve pas une intention malveillante. Vérifiez la correction sur le composant touché et un jeu indépendant.
Consulter les détails techniques
Les extraits permettent de s’exercer à lire les traces du cas. Si vous disposez des outils et des accès nécessaires, le guide de collecte vous aide aussi à rechercher ces informations.
Lire les extraits commentés (reconstitution fictive)
Ces extraits contiennent des valeurs fictives. Certains champs correspondent à ceux des outils documentés ; d’autres réunissent plusieurs sources pour faciliter l’explication. Vos propres exports pourront donc avoir une autre forme. Lisez d’abord les explications des champs, puis repérez-les dans les extraits.
reviewer- Validation de provenance que le pipeline du cas doit enregistrer explicitement ; elle n’est pas créée automatiquement par MLflow.
cohort- Sous-ensemble évalué séparément : une moyenne globale stable peut masquer sa dégradation.
Lignée des données et résultats
JournalExemple synthétique de registre d’expérimentation ; les digests sont des repères, pas de vrais hashes.
run=R17 model_base=M4 dataset=D8 code=COMMIT7 eval_set=E3
run=R18 model_base=M4 dataset=D9 code=COMMIT7 eval_set=E3
dataset D9 added_source=S9 reviewer=missing records_added=120
metric R17 target_cohort=0.98 global=0.96
metric R18 target_cohort=0.20 global=0.96
Préparer une collecte dans votre environnement
Utilisez les sources disponibles dans vos outils et auxquelles vous êtes autorisé à accéder. Vous pouvez comprendre la fiche sans posséder ces outils. Vérifiez que les journaux étaient activés pendant la période étudiée. Gardez l’export original avec son fuseau horaire et sa provenance dans un espace à accès restreint. Pour l’analyse, travaillez sur une copie dont vous avez retiré les secrets.
MLflow Tracking — expériences et runs
- Où les trouver
- Interface MLflow → expérience → runs comparés : paramètres, métriques, jeux de données et artefacts effectivement enregistrés par le pipeline.
- Quoi relever
- Comparer run_id, versions du code et des données, paramètres, métriques par cohorte et artefacts. Retrouver la provenance des nouvelles données et les validations enregistrées par le pipeline.
- Accès et prérequis
- Accès au serveur de suivi. Les versions de données, cohortes et validations doivent être enregistrées explicitement ; MLflow ne les invente pas à partir du modèle final.
GitHub Actions — journaux d’exécution
- Où les trouver
- Dépôt → Actions → exécution concernée → job et étapes ; télécharger les logs encore disponibles et conserver séparément les attestations et artefacts de cette exécution.
- Quoi relever
- Si l’entraînement ou la préparation passent par GitHub Actions, conserver l’exécution, le commit et les artefacts qui ont introduit le jeu de données. Chercher qui a approuvé le changement et avec quels tests.
- Accès et prérequis
- Accès au dépôt et historique non expiré. Le succès d’un job ne garantit ni l’identité de l’artefact déployé ni la légitimité de la modification qui l’a produit.
Si vous pensez être concerné
- Isolez les versions suspectes et gardez les éléments nécessaires à l’analyse.
- Identifiez les données et étapes ayant introduit le changement.
- Revenez à une version fiable puis vérifiez les résultats après reconstruction.
Pour comprendre votre situation et trouver de l’aide : obtenir une assistance sur 17Cyber. Dans une organisation, prévenez aussi le responsable ou prestataire chargé de la sécurité.
Sources et repères pour approfondir
- OWASP GenAI — Data and Model Poisoning — genai.owasp.org
- MITRE ATLAS — atlas.mitre.org
- OWASP GenAI — Data and Model Poisoning — genai.owasp.org
- NIST — Adversarial Machine Learning — csrc.nist.gov